
統計学 第2回のポイント:社会におけるデータ・AI利活用②
2026年9月28日
はじめに:技術の「名前」で何ができるかを語れるようになる
第2回のテーマは、第1回で学んだ社会の変化を支える「技術」と、データが「現場」でどう使われるかでした。ゴールは2つ。技術の名前を聞いて「何ができるか」を説明できること、そして事例をデータサイエンスのサイクルで整理できることです。
後半は、グループで医療・リハビリの事例を調べて1分発表をしました。この記事では、前半の要点を臨床の場面に置き換えて振り返ります。
1. 分析はまず「データを見る」ことから
いきなり難しい分析をせず、まずデータをよく見る。これがデータサイエンスの鉄則です。料理と同じで、材料(データ)を確かめてから調理法(技術)を選びます。
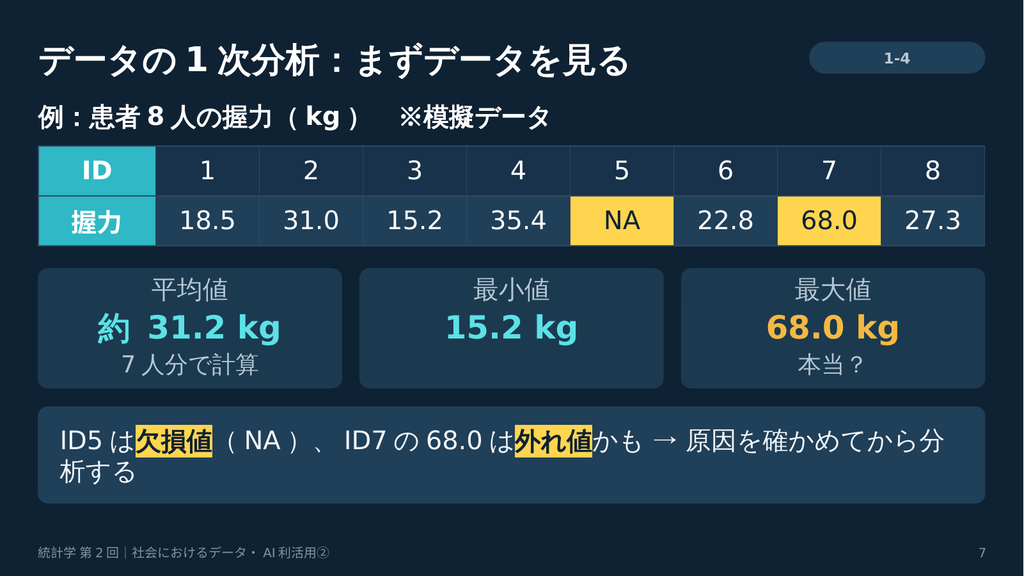
授業では患者8人の握力(模擬データ)を見ました。平均を出す前に、1人は記録がない欠損値(NA)で、もう1人の68.0kgは入力ミスかもしれない外れ値でした。平均・最小・最大などの基礎統計量、欠損値、偏り(男性ばかり?高齢者ばかり?)、そしてグラフ化。この4つをまとめて1次分析と呼びます。
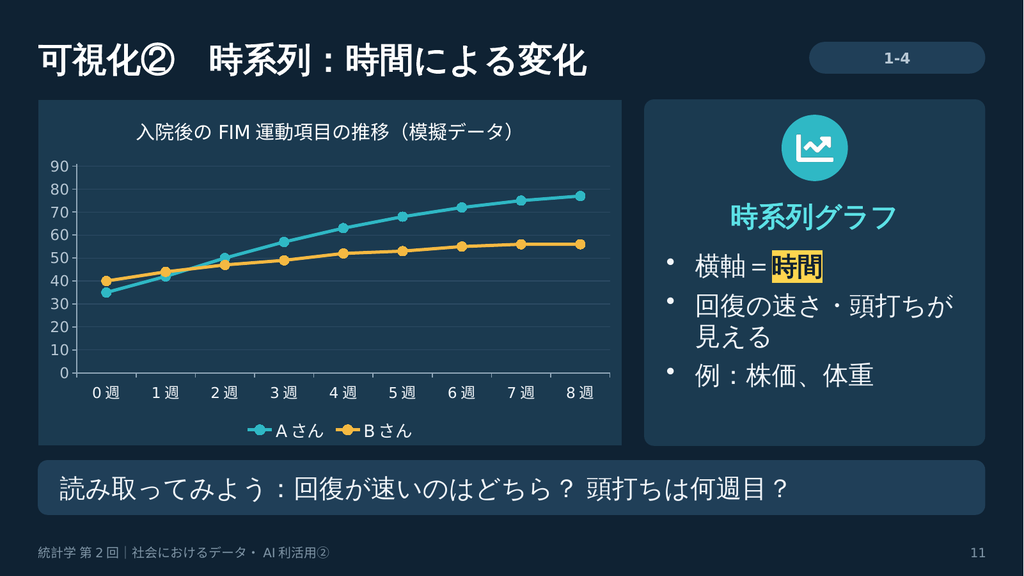
グラフは「何を見たいか」で選びます。種類ごとの量を比べるなら棒グラフ、年齢や握力の分布を見るならヒストグラム、週ごとのFIM(日常生活動作の自立度)の回復なら時系列グラフ、握力と歩行速度の関係なら散布図です。散布図に線を当てはめるのが回帰ですが、関係がある(相関)ことと原因である(因果)ことは別です。第4回で扱います。
診療録の文章、レントゲン画像、発話の音声も、数値に変換すれば同じように分析できます。
2. データを「使う」技術は5つ
データを使う技術は、予測・グルーピング・パターン発見・最適化・シミュレーションの5つで覚えます。
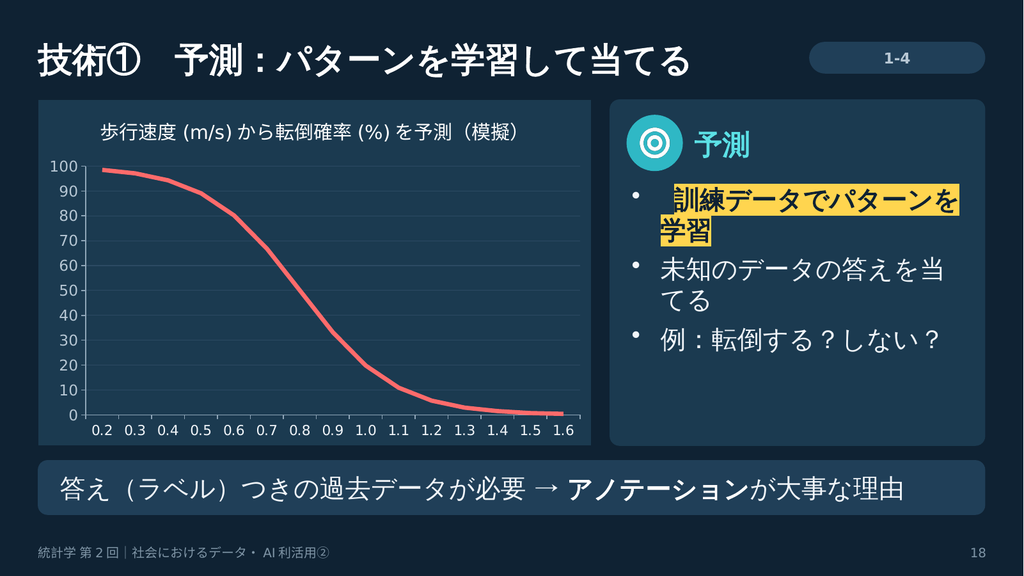
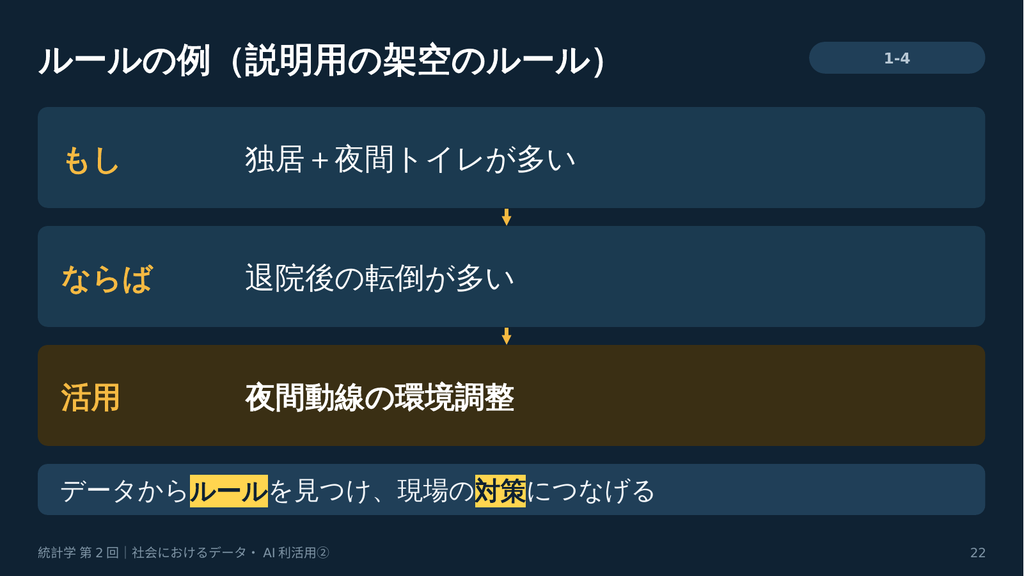
予測は、答え(ラベル)つきの過去データからパターンを学習し、新しい患者が転倒するかどうかを当てる技術です。第1回で「正解ラベルは貴重」と学んだ理由がここにあります。グルーピングは、正解ラベルなしで似た者同士をまとめる技術で、たとえば握力と歩行速度で患者を3タイプに分け、タイプ別に訓練プログラムを設計できます。パターン発見は「独居で夜間のトイレが多い人は退院後の転倒が多い」といった架空のルールを見つけ、夜間動線の環境調整につなげます。最適化はリハ室の予約割当やシフトのように一番よい組み合わせを探し、シミュレーションは感染症の流行や手術のように実機で試せないことをモデルで試します。
生成AIは指示(プロンプト)の出し方で答えが変わります。「あなたは経験10年の作業療法士です。1年生に分かる言葉で3点で」と役割・読み手・形式を指定すると、目的に合った答えになりやすくなります。ただし、患者さんや実習先の情報は入力しない、出力は必ず自分で確かめる、レポートでの利用は科目のルールに従う。この3つは医療系学生の約束です。
3. データサイエンスのサイクル:Netflixもリハも同じ4段階
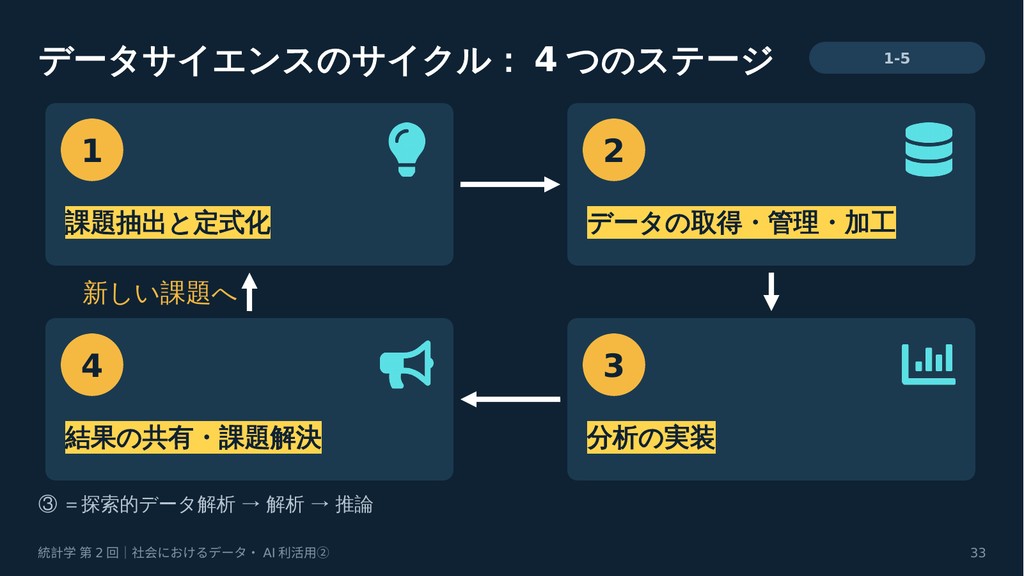
現場でのデータ活用は、①課題抽出と定式化 → ②データの取得・管理・加工 → ③分析の実装 → ④結果の共有・課題解決、という4つのステージを回します。④の後は新しい課題に戻るので「サイクル」です。
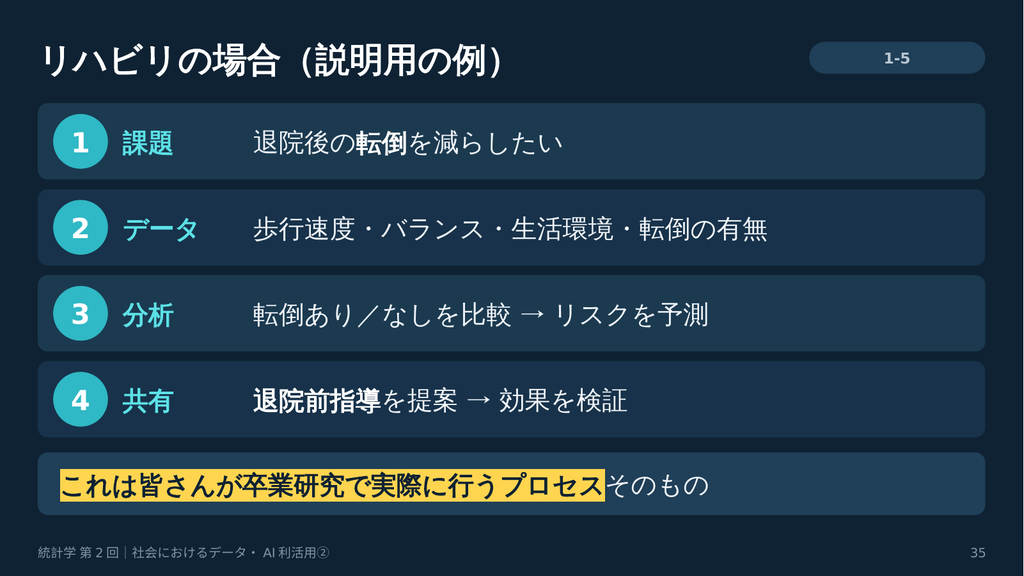
Netflixなら、①誰に何をおすすめするか、②視聴履歴と作品タグ、③探索から推論、そしてオンライン実験、④人気度の予想で製作を支援、となります。リハビリなら、①退院後の転倒を減らしたい、②入院中の歩行速度・バランス・生活環境と退院後の転倒の有無、③転倒あり/なしを比べてリスクを予測、④退院前指導を提案して効果を検証、です。これは皆さんが卒業研究で実際にたどるプロセスそのものです。
最初のステージは課題です。課題が決まらないと、集めるべきデータも決まりません。
4. 最新動向は「名前と一言」で押さえる
最新動向は駆け足でしたが、名前と一言説明を結びつけておきましょう。深層学習は何層にも重ねたニューラルネットで、画像認識が得意。強化学習は自転車の練習のように、経験からよい行動を身につける。転移学習は一般画像で学んだモデルを少ない医用画像で追加学習するように、学んだことを別の課題に活かす。大規模言語モデル(LLM)は膨大なテキストで事前訓練され、生成AIの土台になっています。
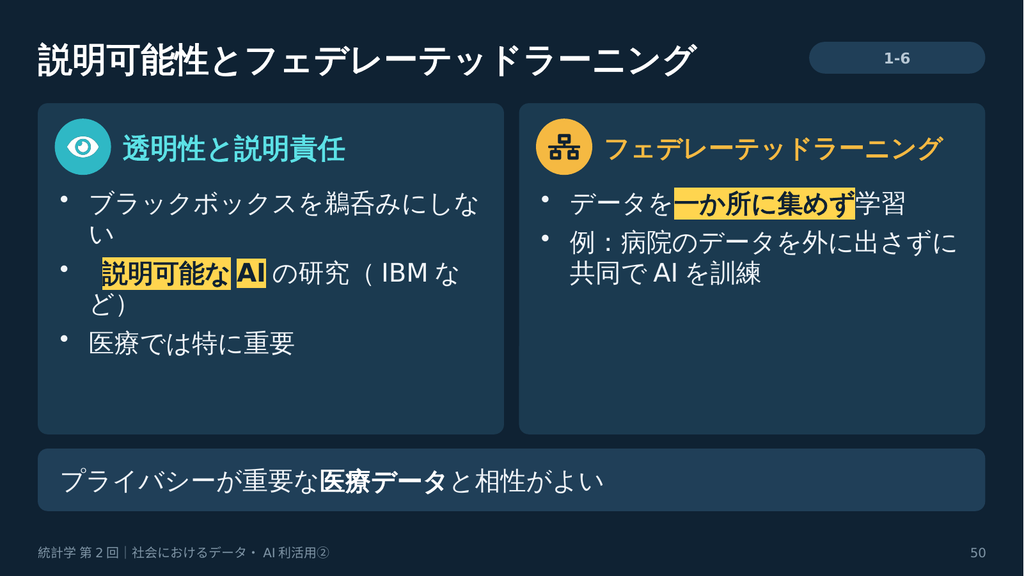
医療と相性がよいのがフェデレーテッドラーニングです。各病院の患者データを外に出さず、置いたままAIを共同で訓練します。また、AIの判断を「なぜそうなるか」説明できること(説明可能性)は、患者さんに説明する医療では特に重要です。
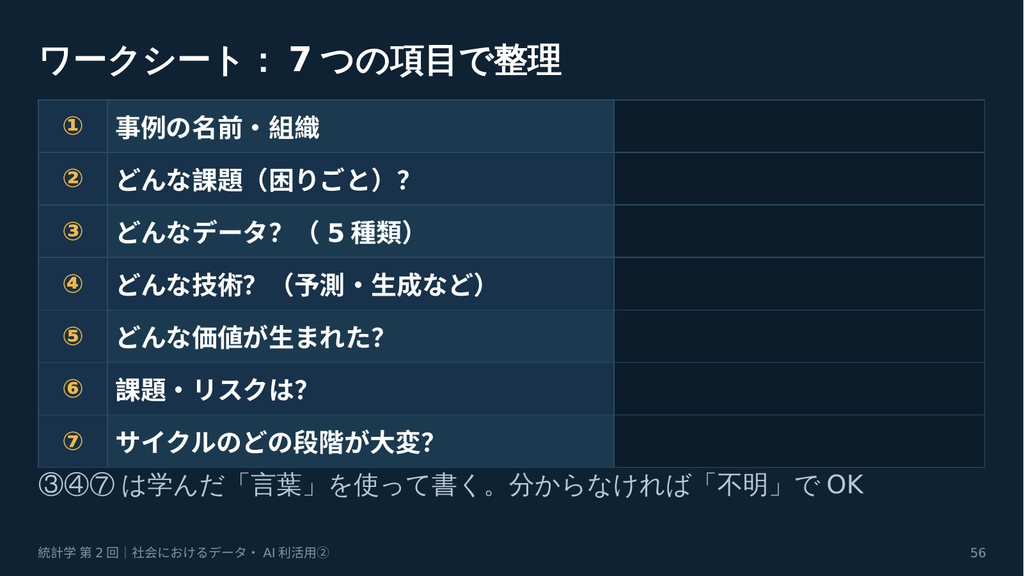
グループワークでは、調べた事例を「課題・データ・技術・価値・リスク・大変な段階」の7項目で整理しました。学んだ言葉で事例を語れたら、今日のゴールは達成です。
まとめと次回予告
第2回の要点は3つです。
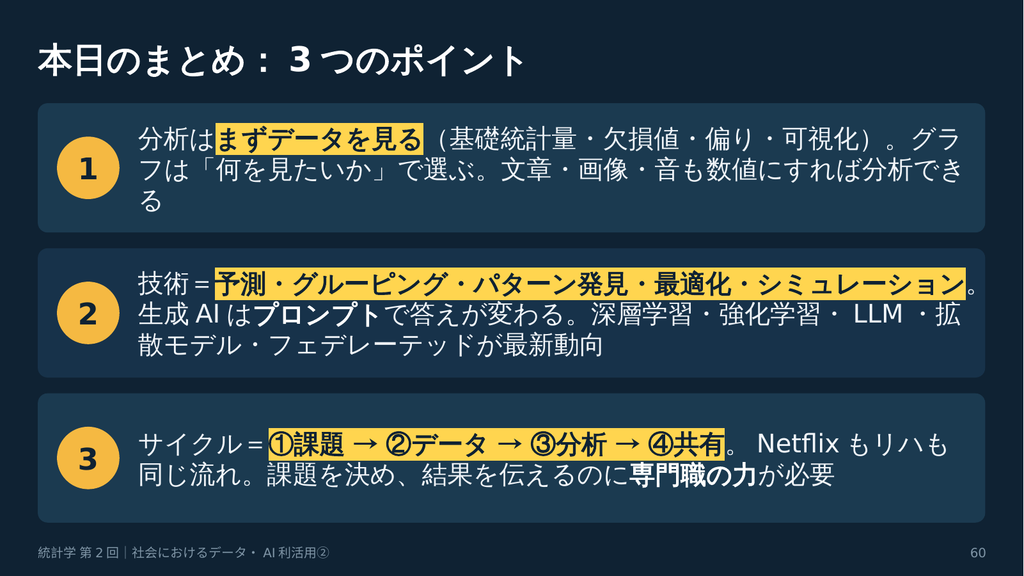
- 分析はまずデータを見る(基礎統計量・欠損値・偏り・可視化)。グラフは「何を見たいか」で選ぶ。文章・画像・音も数値にすれば分析できる
- 技術=予測・グルーピング・パターン発見・最適化・シミュレーション。生成AIはプロンプトで答えが変わる。深層学習・強化学習・LLM・フェデレーテッドラーニングが最新動向
- サイクル=①課題 → ②データ → ③分析 → ④共有。Netflixもリハも同じ流れ。課題を決め、結果を伝えるには専門職の力が必要
第3回からは統計の中身に入ります。データの種類と分布、平均・中央値・ばらつきを、自分の手で計算します。電卓かPCを持ってきてください。事後課題は、今日の事例を1つ選んでサイクルの4段階で整理することです。

コメント