
統計学 第3回のポイント:データを読む①
2026年10月20日
はじめに:今日から「統計の中身」に入る
第3回から、いよいよ統計の中身に入りました。テーマは「1つの変数を読む」。ゴールは3つです。データの種類を見分けて分布の「山の形」を読めること、平均・中央値・標準偏差を計算して意味を説明できること、そして誤差・外れ値・欠測といった「落とし穴」に気づけることです。
この記事では、授業で使った臨床の例を中心に要点を振り返ります。計算は電卓でできるものばかりなので、手を動かしながら読んでみてください。
1. データの種類と「山の形」
統計の第一歩は、データを「表」の形に整えることです。横の行が1人分、縦の列が1つの項目(変数)です。
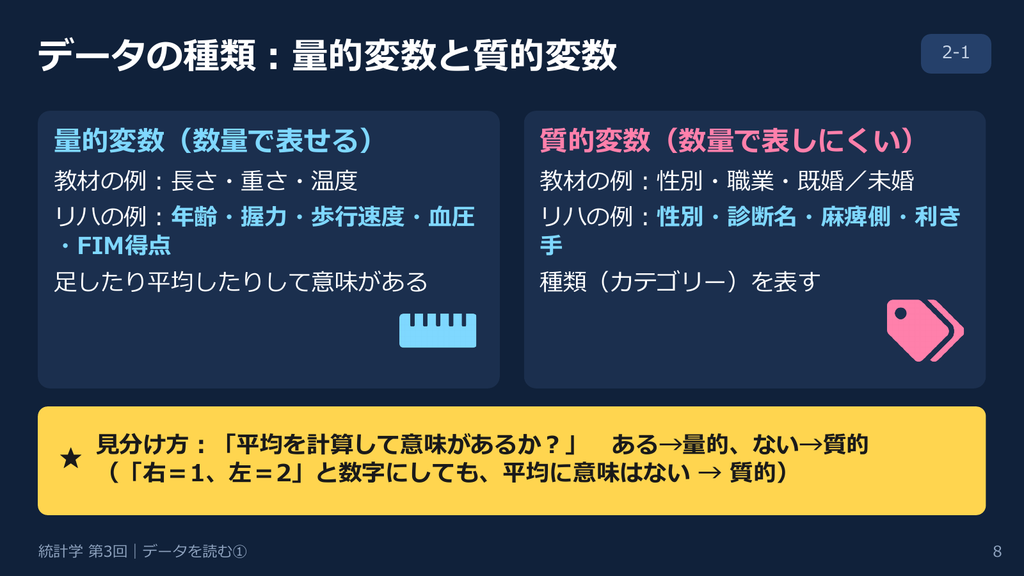
変数には、年齢・握力・歩行速度のような量的変数と、性別・診断名・麻痺側のような質的変数があります。見分け方は「平均を計算して意味があるか」。麻痺側を「右=1、左=2」と入力しても、平均1.4に意味はありません。
リハの評価でよく出るのが尺度の違いです。MMTは0〜5の順番はあっても、「3と4の差」と「4と5の差」が同じとは限りません。こうした順序尺度は、平均より中央値で表します。
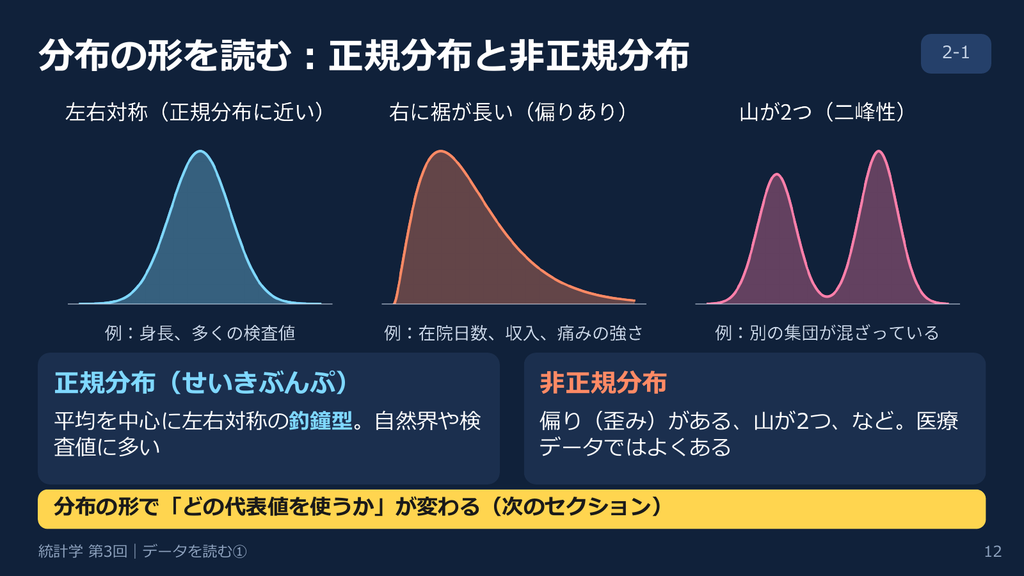
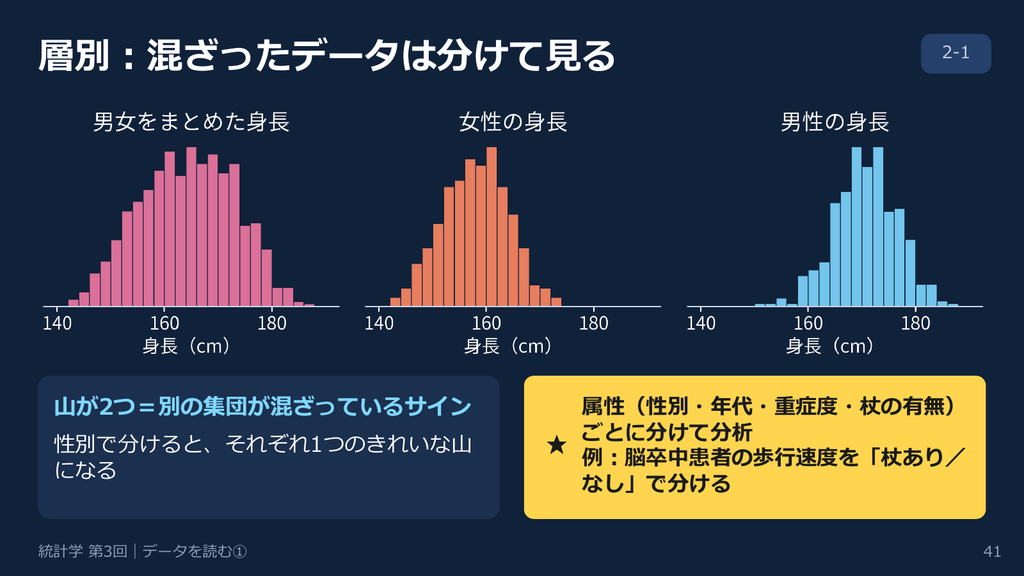
数値が多いときは、度数分布表で範囲ごとに人数を数え、ヒストグラムにして眺めます。患者50人の歩行速度なら、0.8〜1.0 m/sに18人が集まっている、という傾向が一目でわかります。身長や多くの検査値は左右対称の釣鐘型(正規分布)ですが、在院日数や痛みの強さは右に裾が長く、別の集団が混ざると山が2つになります。この「山の形」が、次に使う代表値を決めます。
2. 代表値:3つの「真ん中」を使い分ける
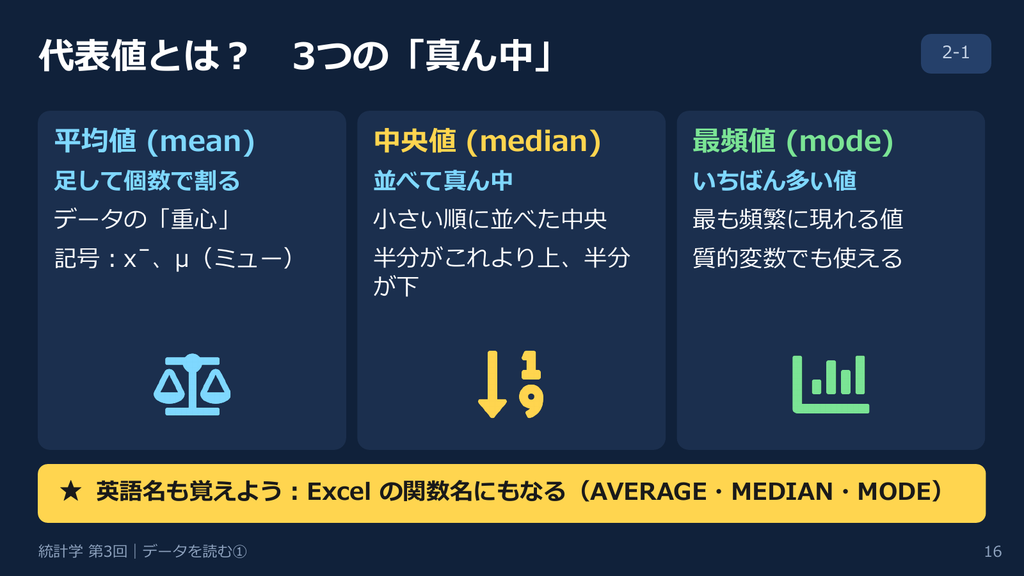
代表値は、たくさんの数を1つの数で代表させるものです。足して個数で割る平均値、小さい順に並べて真ん中の中央値、いちばん多く現れる最頻値の3つがあります。
5人の在院日数が20、25、22、120、23日だったとします。平均は210÷5=42日。でも並べると20、22、23、25、120で、中央値は23日です。120日の1人に平均が引っ張られていて、「典型的な患者」に近いのは中央値のほうです。
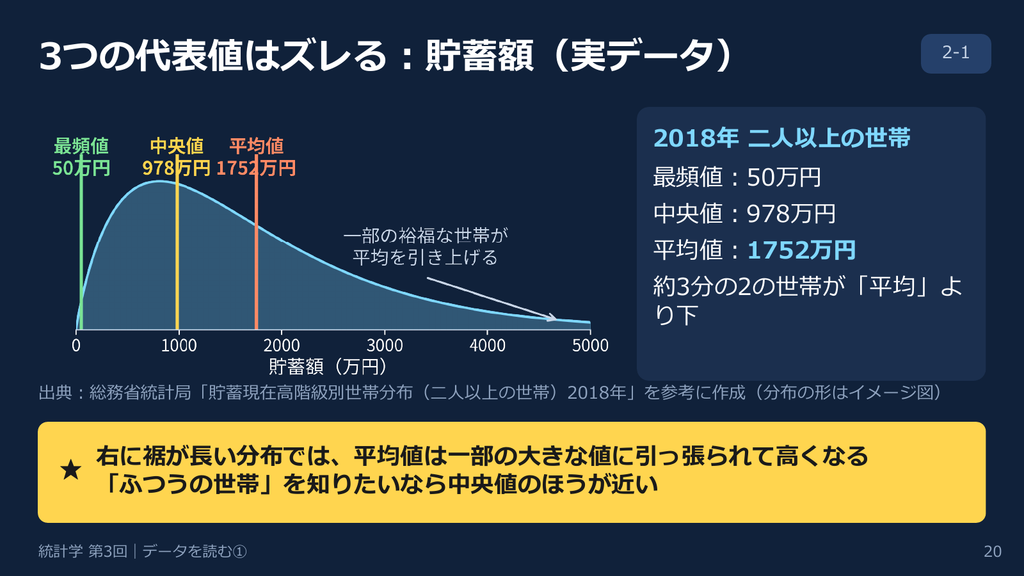
実データでも同じことが起こります。2018年の二人以上の世帯の貯蓄額は、最頻値50万円、中央値978万円、平均値1752万円。約3分の2の世帯が「平均」より下でした。右に裾が長い分布では、平均は一部の大きな値に引っ張られて高くなります。
使い分けの目安は、左右対称なら平均値(+標準偏差)、偏りや外れ値があれば中央値(+四分位範囲)、質的変数なら最頻値と割合です。論文を読むときは、「平均±SD」か「中央値(範囲)」のどちらで報告されているかに注目してください。
3. ばらつき:平均が同じでも中身は違う
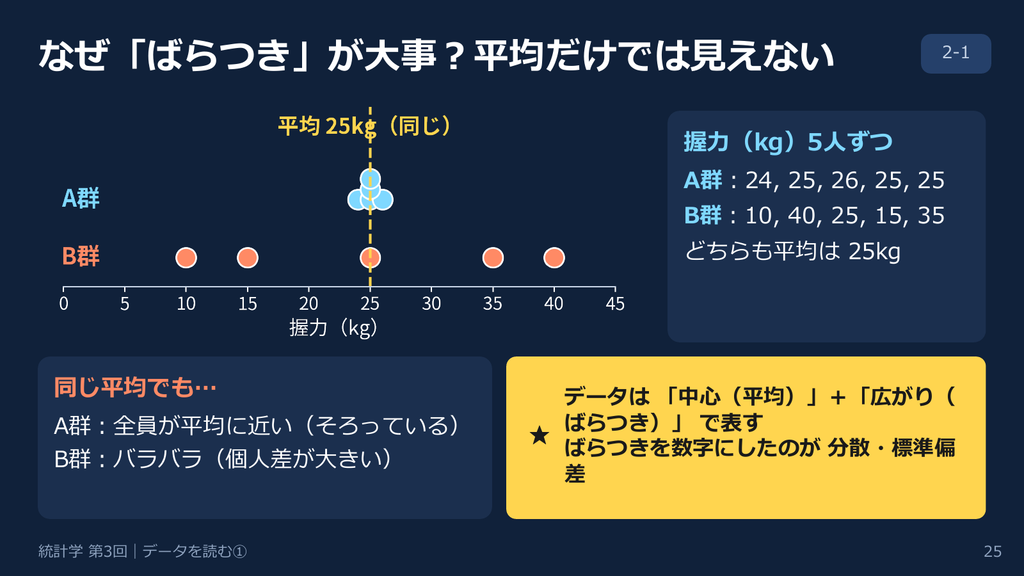
握力を5人ずつ測って、A群が24、25、26、25、25kg、B群が10、40、25、15、35kgだったとします。平均はどちらも25kgですが、A群はそろっていて、B群は個人差が大きい。データは「中心(平均)」と「広がり(ばらつき)」の両方で表します。
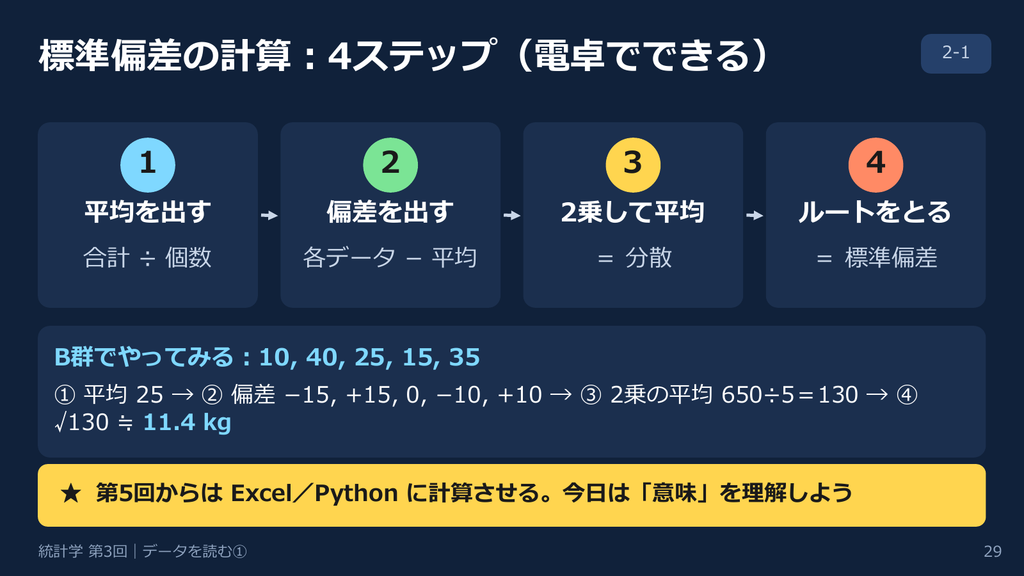
ばらつきの計算は4ステップです。①平均を出す、②各データから平均を引いて偏差を出す、③偏差を2乗して平均すると分散、④ルートをとると標準偏差(SD)。B群なら偏差は−15、+15、0、−10、+10で、2乗の平均は130、ルートをとって約11.4kgです。偏差をそのまま足すとプラスとマイナスが打ち消し合って0になるので2乗し、単位がkg²になってしまうのでルートで元に戻す。これが分散とSDの関係です。標準偏差は「平均からの平均的な距離」とイメージしてください。
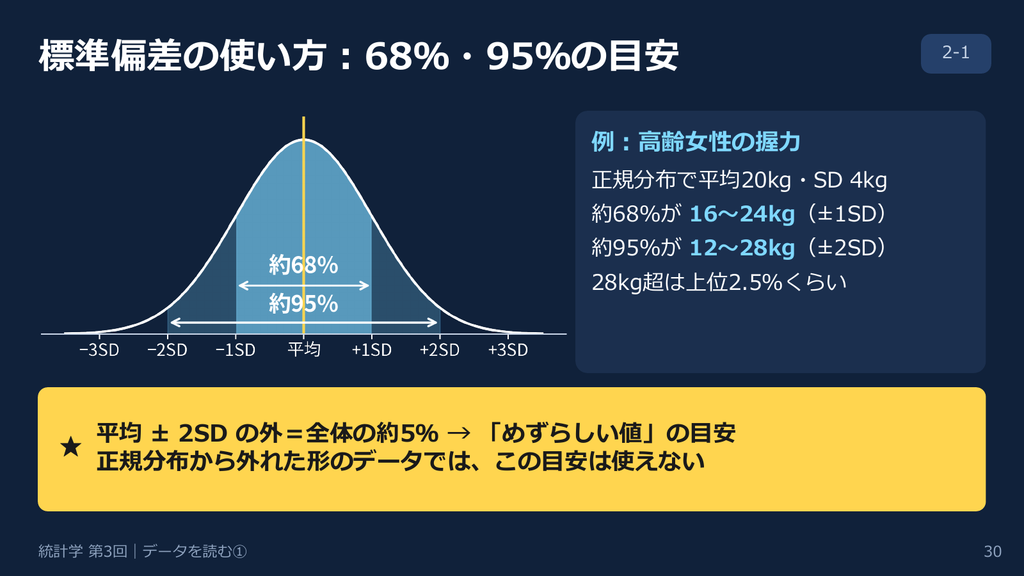
正規分布なら、平均±1SDに約68%、±2SDに約95%が入ります。高齢女性の握力が平均20kg・SD 4kgなら、約95%が12〜28kgに入り、28kg超は上位2.5%ほどです。平均±2SDの外は「めずらしい値」の目安になります。偏差値はこの考え方を「平均50、1SDで10」にそろえたもので、IQや骨密度のTスコアも同じ仕組みです。
4. 数字をうのみにしない:4つの落とし穴
測った値は、本当の値に誤差が足されたものです。握力を3回測ると24.5、25.2、24.8kgのように毎回ずれる偶然誤差は、繰り返して平均すれば小さくなります。一方、機器のクセや測り方で毎回同じ方向にずれる系統誤差は、平均しても消えません。測定方法を統一して防ぎます。
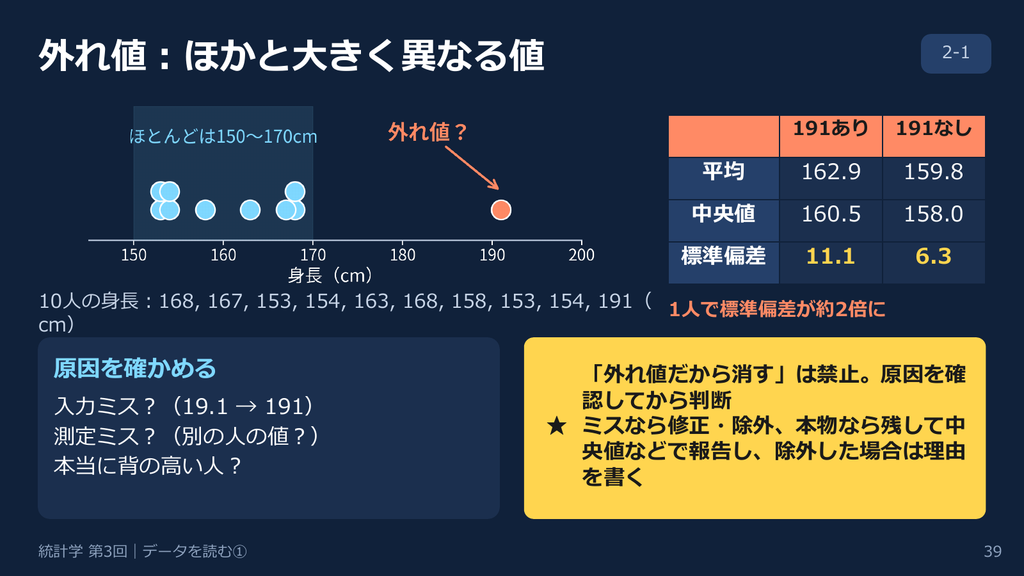
外れ値は「ほかと大きく異なる値」です。10人の身長に191cmが1人いるだけで、標準偏差は6.3から11.1へほぼ2倍になります。ただし「外れ値だから消す」は禁止。入力ミス(19.1→191)か、測定ミスか、本当に背の高い人かを確かめてから判断します。
退院後の追跡調査で、調子の悪い人ほど来院しなくなったら、残った人だけの平均は実際より良く見えます。欠測や打ち切りがあるときは「誰のデータが欠けているか」を考えてから結論を出してください。
ヒストグラムの山が2つなら、別の集団が混ざっているサインです。性別や年代、杖の有無などで分けて見る。これを層別といいます。
まとめと次回予告
第3回の要点は3つです。
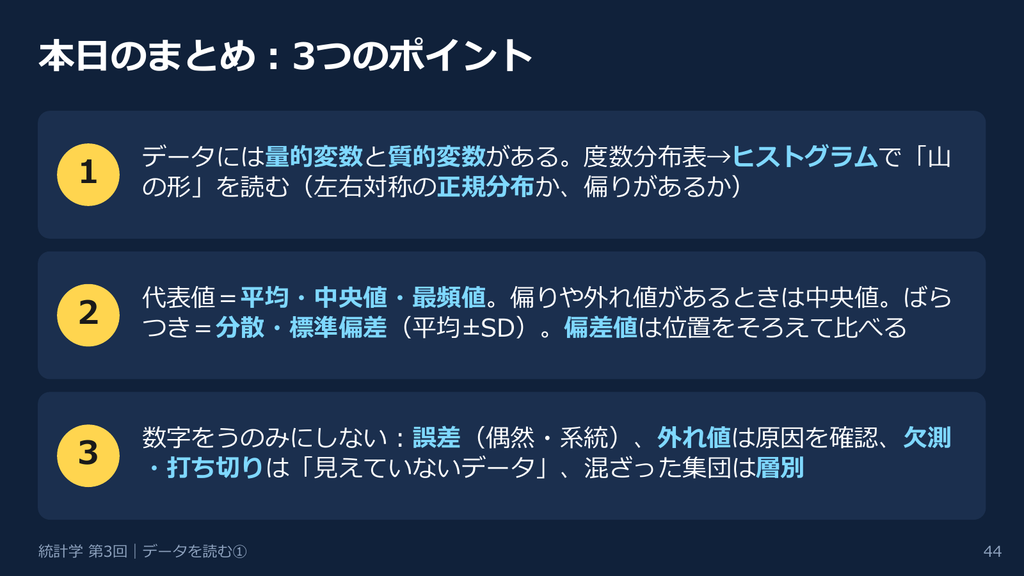
- データには量的変数と質的変数がある。度数分布表→ヒストグラムで「山の形」を読む(左右対称か、偏りがあるか)
- 代表値=平均・中央値・最頻値。偏りや外れ値があるときは中央値。ばらつき=分散・標準偏差(平均±SD)。偏差値は位置をそろえて比べる
- 数字をうのみにしない。誤差は偶然と系統、外れ値は原因を確認、欠測・打ち切りは「見えていないデータ」、混ざった集団は層別
第4回は「2つの変数の関係」を読みます。散布図と相関係数、そして「相関があっても因果とは限らない」という話です。事後課題は、身近なデータ5個で平均と中央値を計算してみること。電卓かPCを忘れずに。

コメント