
【ブログ】統計学 第6回のポイント:データを使う
2026年11月5日
はじめに:「読む・説明する」から「自分の手で使う」へ
第3〜5回でデータを「読む・説明する」方法を学びました。第6回は、公的統計の実データを自分の手で集計し、結果を説明するところまで体験する回です。第2回で学んだデータサイエンスのサイクルでいえば、②データの取得・加工と③分析の実装にあたります。
ゴールは3つ。機械判読可能なデータ(csv・整然データ)を説明できること、表計算ソフトで合計・平均・並べ替え・割合を計算できること、SSDSEの実データを集計して文章で説明できることです。
1. 使えるデータは「機械が読める形」
分析の第一歩は、データを「使える形」で手に入れることです。コンピュータがそのまま処理できる形式のデータを、機械判読可能(マシンリーダブル)なデータといいます。代表はcsvファイルで、カンマで区切った「ただの文字」なので、どのソフトでも開けます。紙の記録、PDFの表、画面のスクリーンショットは、人には読めても機械には読めません。数字が「絵」になっているからです。
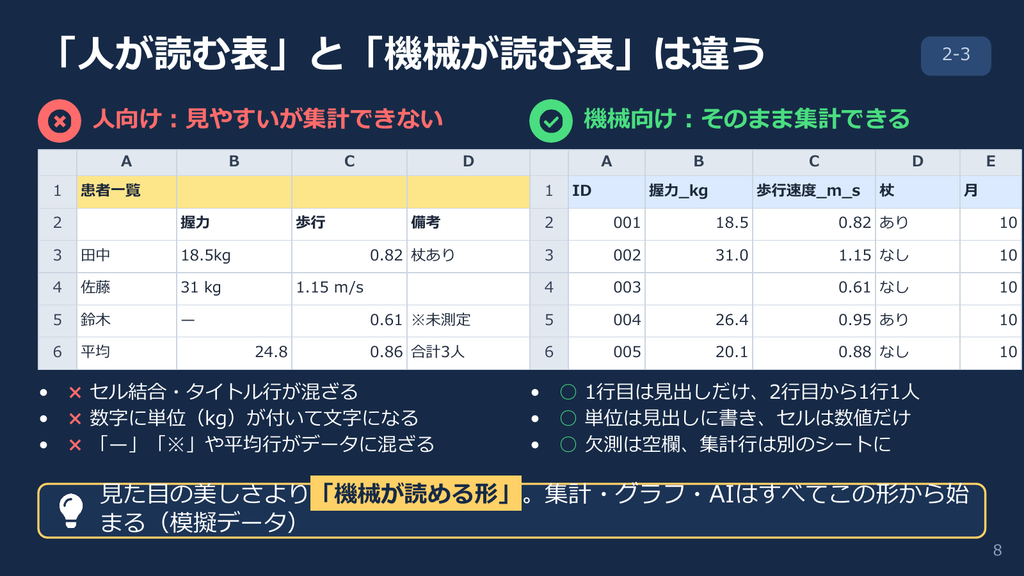
臨床記録の表(模擬データ)で考えてみましょう。「田中 18.5kg」「鈴木 —(未測定)」のように、数字に単位が付いたり、記号や平均の行が混ざったり、セルが結合されていたりする表は、見やすくても集計できません。機械が読む表は、1行目は見出しだけ、2行目から1行1人、単位は見出しに書いてセルは数値だけ、欠測は空欄にします。
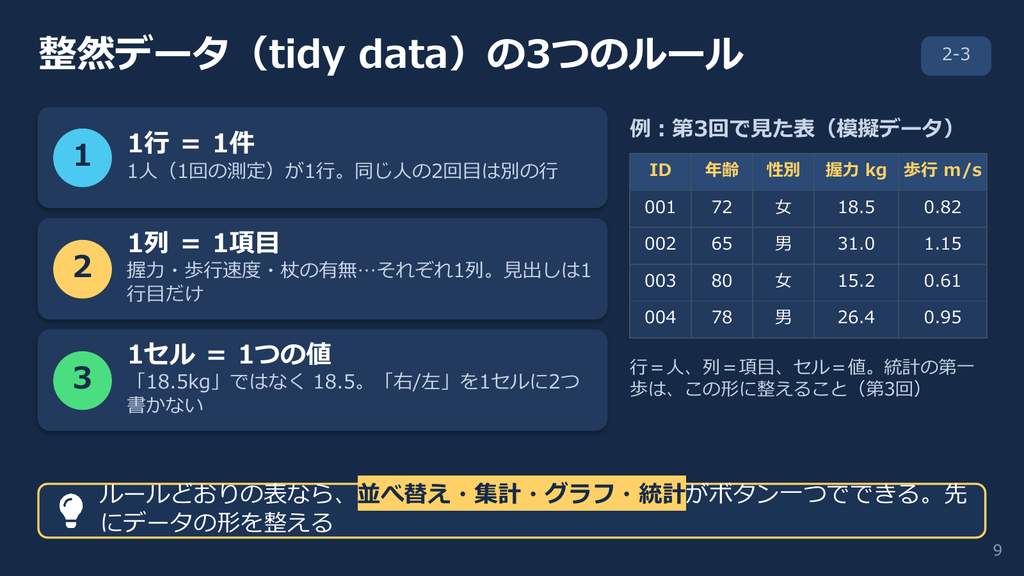
これを整然データ(tidy data)といい、ルールは3つです。1行=1件、1列=1項目、1セル=1つの値。「18.5kg」ではなく18.5、「右/左」を1つのセルに2つ書かない。この形になっていれば、並べ替え・集計・グラフ・統計がボタン一つでできます。
2. 表計算ソフトの基本操作:関数・並べ替え・割合
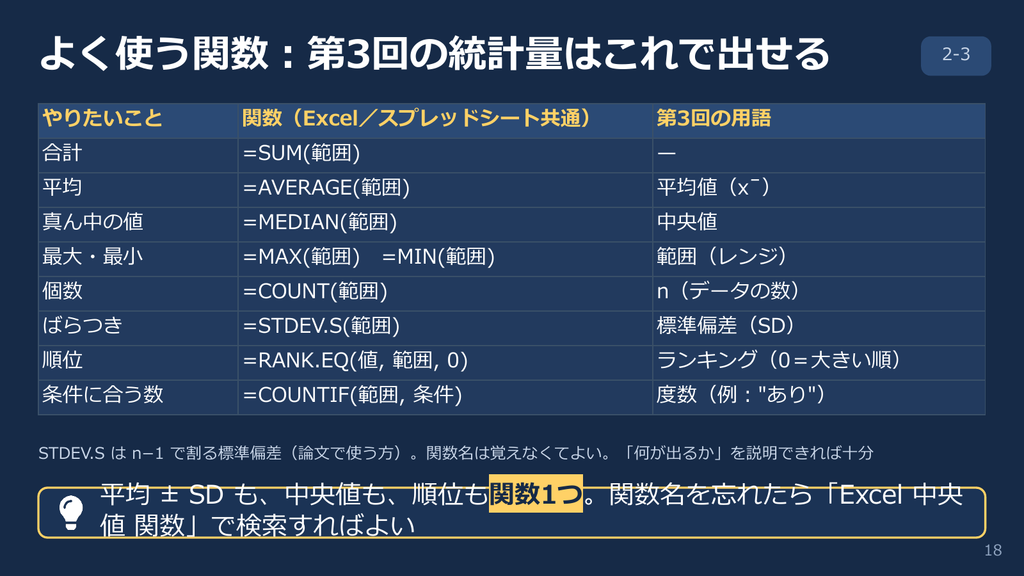
Excelでもスプレッドシートでも、考え方は同じです。セルは番地で呼び(B2)、範囲はコロンでつなぎ(B2:B11)、=で始めて「関数名(範囲)」と書けば計算されます。=SUM(B2:B11)で合計、=AVERAGE(B2:B11)で平均。第3回で手計算した中央値(MEDIAN)や標準偏差(STDEV.S)、順位(RANK.EQ)も関数1つで出せます。関数名は覚えなくてよく、「何が出るか」を説明できれば十分です。
同じ計算を何十行も手で打たず、1つ作ってコピーします。コピーすると行番号は一緒にずれる(相対参照)ので、全体の合計のように固定したいセルには$を付けます(絶対参照)。
並べ替えは「行ごと」が鉄則です。1列だけを並べ替えると、No.と値の対応がずれて別の人のデータになってしまいます。フィルターで「杖ありの人だけ」に絞って平均を出せば、第3回の層別がExcelでできます(模擬データでは杖あり5人の平均10.1秒、杖なし5人は8.6秒)。
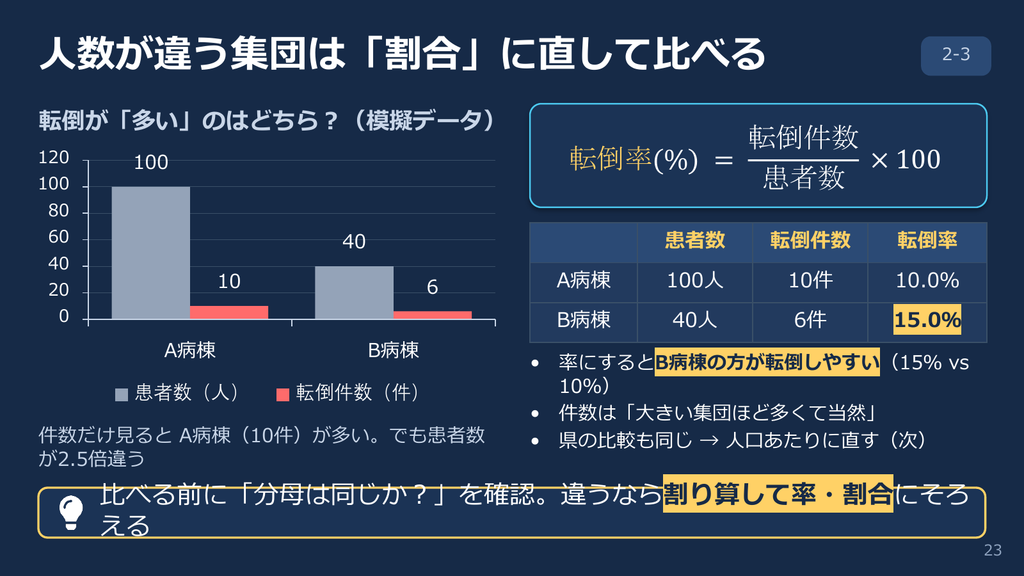
人数が違う集団は、割合に直してから比べます。A病棟は患者100人で転倒10件、B病棟は40人で6件。件数だけ見るとA病棟が多いですが、転倒率はA病棟10%、B病棟15%で、転倒しやすいのはB病棟です。県を比べるときも同じで、医師数は「人口10万人あたり」に直します。比べる前に「分母は同じか?」と確認する習慣が、今日の演習の中心です。
3. SSDSE:公的統計を「すぐ使える表」に
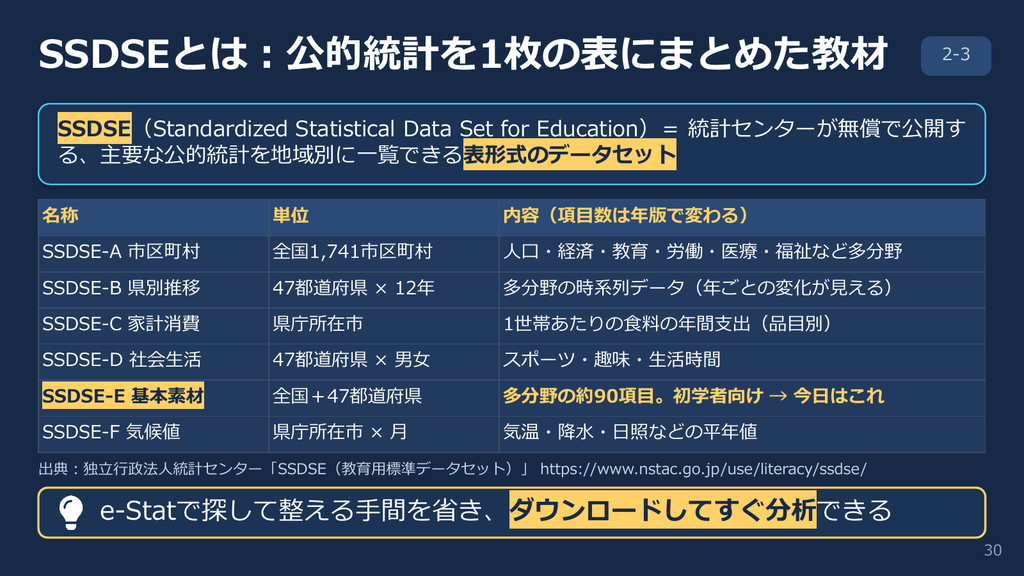
公的統計は、e-Stat(政府統計の総合窓口)から無料で、機械判読可能な形で手に入ります。ただ、探して整える手間がかかります。そこで便利なのがSSDSE(教育用標準データセット)です。統計センターが無償で公開していて、主要な公的統計を地域別の1枚の表にまとめてあります。授業で使うSSDSE-E(基本素材)には、全国と47都道府県の人口・医療・福祉など約90項目が入っています。欠測のない「完備データ」なので前処理がいらず、自分の県のデータがあるのも魅力です。
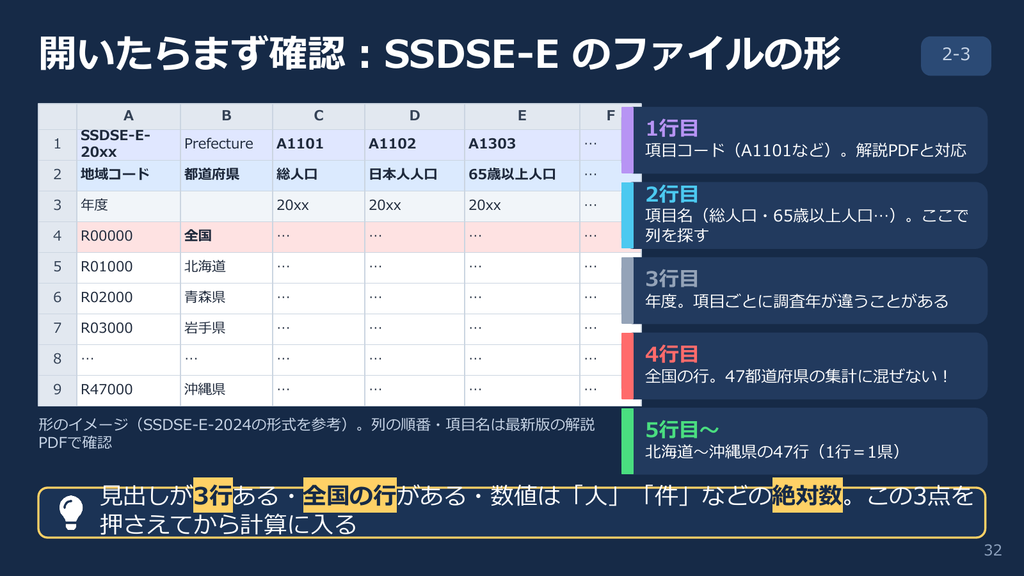
開いたら、3点を確認します。見出しが3行ある(項目コード・項目名・年度)、4行目に全国の行がある、数値は「人」「件」などの絶対数である。全国の行を47県に混ぜると順位が1つずれるので要注意です。
病院では、病床稼働率や平均在院日数、転倒件数を電子カルテから自動集計してダッシュボードに表示するBIツールが使われ始めています。表計算ソフトで集計→可視化→判断の流れを身につけておけば、その延長です。
4. 解析演習:自分の県の高齢化率は何位?
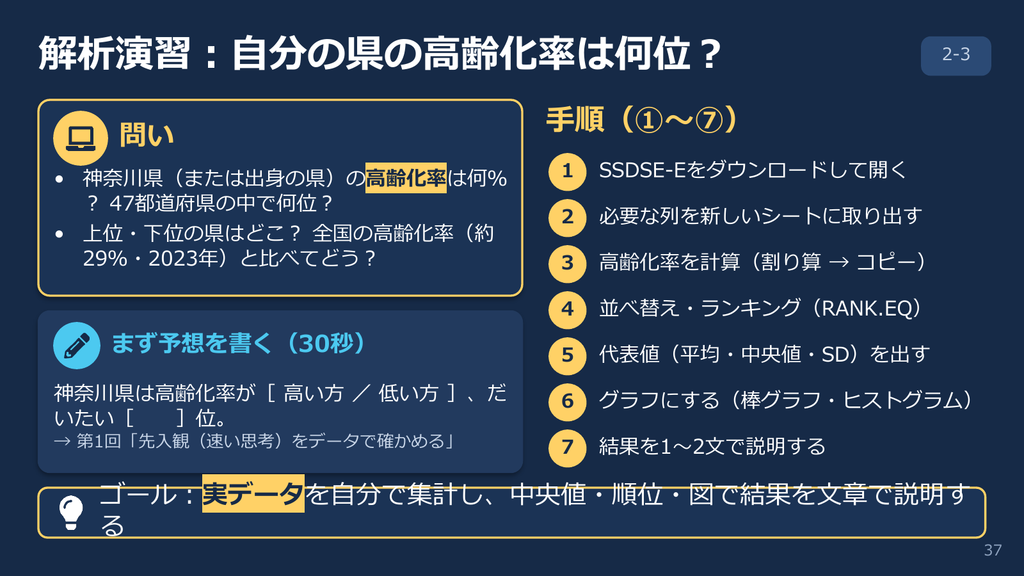
演習の問いは「神奈川県(または出身の県)の高齢化率は何%で、47都道府県中何位か」。まず予想を書いてから始めました。第1回の「先入観(速い思考)をデータで確かめる」の実践です。
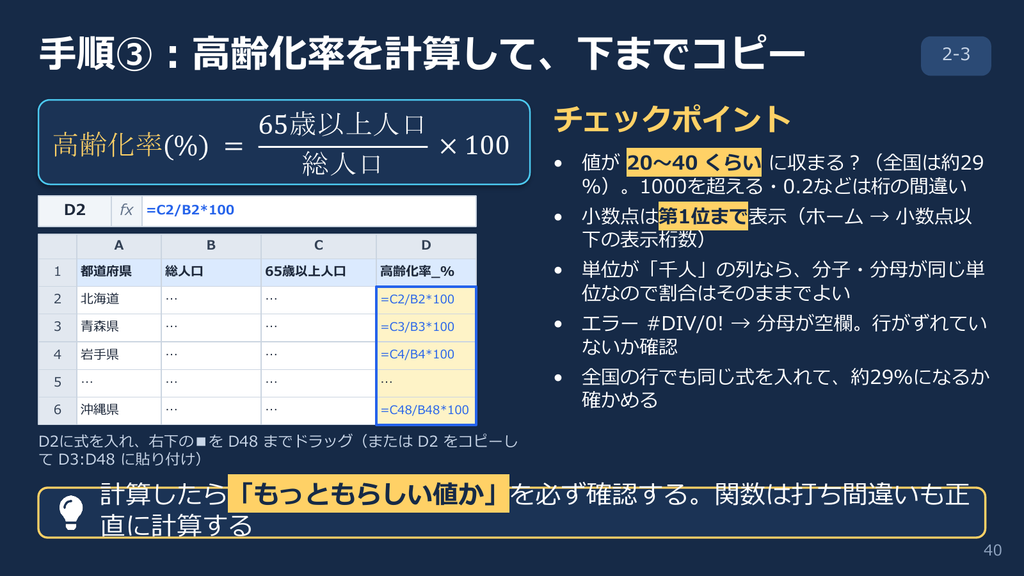
手順は7つ。①SSDSE-Eをダウンロードして開く、②都道府県名・総人口・65歳以上人口の列だけを新しいシートに取り出す、③高齢化率=65歳以上人口÷総人口×100を計算して下までコピー、④並べ替えかRANK.EQで順位をつける、⑤平均・中央値・最大・最小・SDを出す、⑥上位5県・下位5県と自分の県の棒グラフ、またはヒストグラムを描く、⑦結果を1〜2文で説明する。
計算したら「もっともらしい値か」を必ず確認します。高齢化率は20〜40%くらいに収まるはずで、全国は約29%。1000を超えたり0.2になったりしたら桁の間違いです。全国の行でも同じ式を入れて約29%になるか確かめると安心です。
結果は型に当てはめて書きます。「47都道府県の高齢化率の中央値は○%(最小○%〜最大○%)だった。神奈川県は○%で47都道府県中○位であり、全国の中では高い/低い方だった(図1)」。順位は分母つきで書き、「高齢化率が高い=悪い県」のような価値判断は書きません。解釈は考察に分けて書く。第15回の発表の型です。
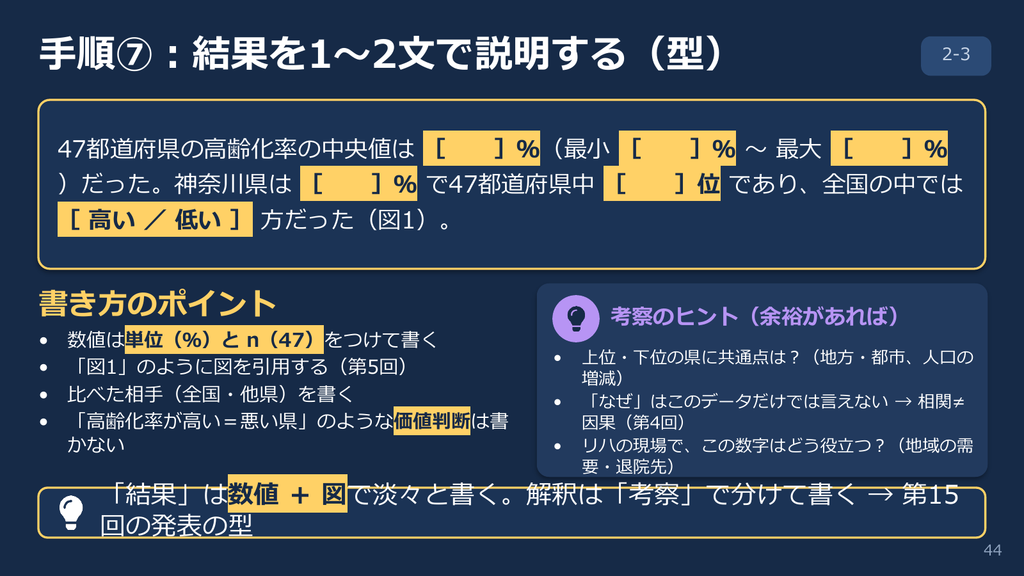
余裕があれば、医師数を人口10万人あたりに直して高齢化率との散布図を描き、=CORRELで相関係数を出してみましょう。関係が見えても原因とは限らない、は第4回のとおりです。リハの現場なら、この数字は地域の需要や退院先を考える材料になります。
まとめと次回予告
第6回の要点は3つです。
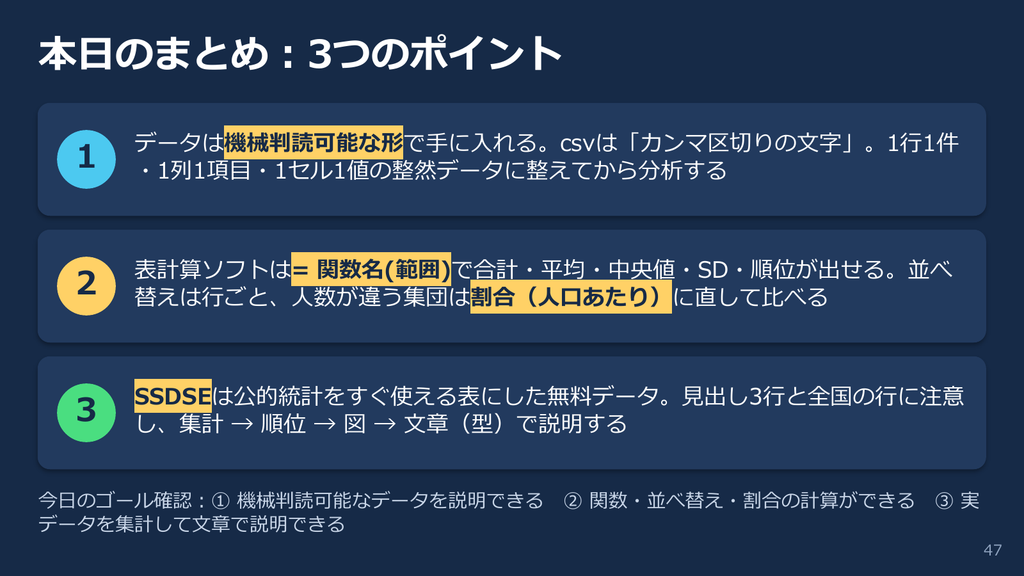
- データは機械判読可能な形で手に入れる。csvは「カンマ区切りの文字」。1行1件・1列1項目・1セル1値の整然データに整えてから分析する
- 表計算ソフトは=関数名(範囲)で合計・平均・中央値・SD・順位が出せる。並べ替えは行ごと、人数が違う集団は割合(人口あたり)に直して比べる
- SSDSEは公的統計をすぐ使える表にした無料データ。見出し3行と全国の行に注意し、集計→順位→図→文章(型)で説明する
第7回からは、自分でデータを集める段階に入ります。母集団と標本抽出を学び、GoogleフォームでグループごとにWEB調査を作って、回収の流れを体験します。その結果は第15回の発表で使います。事後課題は、演習の提出物(表・図・説明文・代表値)をLMSへ。PCとGoogleアカウントを忘れずに。

コメント